Données de santé : l'analyse du modèle de la UK Biobank
Rédigé par Sohane Aissa
-
24 septembre 2026Le 14 avril 2026, le Financial Times et le The Guardian révélaient que les données génétiques de plus de 500 000 citoyens britanniques avaient été mises en vente sur la plateforme chinoise Alibaba. Retour sur cet incident qui met en lumière l’importance d’une bonne sécurisation des systèmes de partage de données pour la recherche en santé.
La UK Biobank : une ressource scientifique ouverte
L’ambition première et la constitution de la base
Lancée en 2003 et ouverte aux chercheurs dès 2012, la UK Biobank (UKB) est une base de données de santé constituée spécifiquement pour la recherche scientifique. Elle est gérée par une organisation à but non lucratif, pilotée par un conseil d’administration scientifique indépendant et hébergée sur les serveurs de l’Université de Manchester. Pour son financement, la structure s'appuie à la fois sur des fonds publics, via le Medical Research Council, et sur des fonds privés à travers le Wellcome Trust, une fondation caritative.
Cette cohorte est devenue l’une des plus importantes au monde : elle rassemble les données de plus de 500 000 volontaires britanniques âgés de 40 à 69 ans au moment de leur inclusion dans l’étude, et ses ressources ont déjà permis plus de 18 000 publications scientifiques. Elle permet aux scientifiques de suivre l’évolution de leur état de santé sur plusieurs décennies afin d’étudier les facteurs de risque des maladies chroniques complexes (cancers, diabètes, maladies cardiovasculaires, etc.).
Le protocole suivant a été mis en place afin d’alimenter cette base de données :
- Les personnes ont d'abord été identifiées à partir de leurs dossiers de santé, grâce aux registres officiels fournis par le NHS (National Health Service, le service de santé public britannique) avant de recevoir une lettre d’information leur proposant de participer à l’étude et de recueillir leur consentement à l’utilisation de leurs données dans le cadre de recherches.
- Ils ont ensuite rempli des questionnaires médicaux détaillés (habitudes de vie, alimentation, historique familial) suivi d’une série de mesures physiques (taille, poids, etc.). Les équipes ont également collecté des échantillons biologiques (sang, salive, urine) pour les analyses biochimiques et le séquençage de leur ADN.
- Pour au moins 60 000 d'entre eux, ce parcours a été enrichi à intervalle régulier par des examens d'imagerie approfondis (notamment des IRM du cerveau et du cœur), afin d'observer en détail la structure et l'évolution de leurs organes.
- Lors de leur inclusion, les participants ont accepté non seulement cette collecte initiale, mais également l’enrichissement continu et permanent de la base de données par la mise à jour de leurs informations médicales versées directement par le NHS depuis leur dossier médical informatisé.
Le mécanisme de pseudonymisation : protéger les volontaires face au risque de ré-identification ?
Pour protéger les volontaires qui ont accepté de partager cette quantité importante d'informations sensibles, la UK Biobank applique un protocole de « dé-identification » :
- La création de l'identifiant interne (ou PID) : les données sont pseudonymisées de manière sommaire dès leur collecte, c’est-à-dire que les noms et prénoms de la personne participant à la recherche sont supprimés des fichiers de travail et remplacés par un identifiant permanent interne, appelé PID (Participant Identifier). Ce code, accessible à un nombre restreint de membres du personnel de la UKB, sert uniquement à rattacher les nouveaux dossiers médicaux du NHS aux bons échantillons au fil des années. Il s’agit d’un identifiant interne, qui fait l’objet de mesures de sécurité particulières et n'est jamais fourni aux chercheurs.
- La substitution par un code projet (ou EID) : lorsque les données sont mises à la disposition d’un chercheur, l'identifiant interne (PID) est remplacé par un autre identifiant, spécifique au projet de recherche, appelé EID (External Identifier).
Ainsi, un même participant est désigné par un identifiant EID différent selon les projets de recherche, afin de limiter les possibilités de recoupement entre les bases de données. Si une même équipe de recherche mène deux études distinctes sur la base, elle devra faire deux demandes indépendantes et si une même personne est présente dans les deux jeux de données, elle sera identifiée par deux codes EID différents.
L'accès aux données et le protocole de partage aux équipes de recherche
La politique de mise à disposition des données de la UK Biobank se caractérise par une volonté d’ouverture internationale. Ainsi, tout chercheur peut demander à accéder aux données de la cohorte, qu’il appartienne au secteur académique, hospitalier ou au secteur privé commercial (comme les entreprises de biotechnologie ou les laboratoires pharmaceutiques), et ce quelle que soit la nationalité de sa structure.
Pour obtenir ces fichiers, le parcours des chercheurs s'organise en trois étapes :
- Ils enregistrent leur institution de rattachement et soumettent un formulaire détaillant leur projet scientifique. L'institution fournit une description administrative de sa structure, tandis que les chercheurs s'engagent à respecter les règles, notamment en matière de protection des données, sur un mode déclaratif (il n’y a par exemple pas d’audit préalable de la sécurité informatique de leurs serveurs par la biobanque).
- La demande est ensuite examinée par un comité scientifique indépendant (Access Committee), composé de scientifiques, de médecins, de juristes, de spécialistes de la conformité et d'experts en éthique. Ce comité évalue la qualité scientifique du projet et son respect des exigences éthiques.
- Une fois la demande approuvée, le chercheur signe un Material Transfer Agreement (MTA). Par ce contrat, l'organisme demandeur s'engage à traiter les données conformément au RGPD britannique. L'institution et ses chercheurs sont tenus de respecter les finalités du projet, de mettre en œuvre des mesures de sécurité appropriées, de ne pas partager les données avec des tiers et de s'abstenir de toute tentative de réidentification ou de contact avec les volontaires. Les chercheurs peuvent recevoir ensuite plusieurs téraoctets de données directement sur leurs infrastructures pour commencer leurs analyses.
Une base de données qui est aussi un actif stratégique et les risques associés
La UK Biobank constitue également un actif financier stratégique. En signant le formulaire de consentement, les participants qui acceptent que leurs données soient utilisées déclarent expressément « renoncer à tous leurs droits sur ces échantillons » qu'ils « donnent à la UK Biobank » (« relinquish all rights to these samples which I am donating to UK Biobank »). Le texte précise également que les volontaires ne pourront tirer aucun avantage financier des éventuels développements commerciaux ou traitements issus des recherches menées sur la base. Cette renonciation s'applique exclusivement à la propriété matérielle des échantillons biologiques et aux droits de propriété intellectuelle qui pourraient en découler, sans impacter leurs droits sur leurs données personnelles garantis par le RGPD (notamment le droit de retrait).
Bien que la structure se définisse comme « l'intendant » (steward) de cette ressource pour le bien public, ses conditions de gouvernance et ses statuts juridiques ont explicitement anticipé le scénario de la faillite ou de la liquidation de l’organisme, en prévoyant la possibilité d’un transfert ou d'une revente totale de la base de données à un tiers. Il existe des précédents – relativement récents – de vente ou de faillite, concernant des acteurs gérant des bases de données génétiques, ce qui n’est pas sans soulever des enjeux pour les personnes et leurs droits :
- Le cas de la base généalogique GEDmatch illustre le risque lié au rachat d'infrastructures. Ce site, conçu à l'origine pour retrouver des proches, a été entièrement revendu à l'entreprise Verogen, qui a ouvert l'accès de la base au FBI pour mener des enquêtes policières et résoudre des cold cases (des affaires criminelles anciennes restées non élucidées). Après ce rachat, en juillet 2020, la plateforme a subi deux cyberattaques successives. Comme le rapporte le New York Times, une faille de sécurité a écrasé les paramètres de confidentialité du site, ouvrant alors l'accès du FBI et des forces de l'ordre aux profils de près d'un million d'utilisateurs qui avaient pourtant explicitement refusé d'y participer.
- La crise traversée par l'entreprise 23andMe soulève également cette question de la durabilité ou pérennité de ce type de bases. Le pionnier américain des tests génétiques grand public s’appuyait sur un modèle consistant à vendre des tests à faible coût, avant de subir une fuite de données en octobre 2023 touchant près de 7 millions de clients. Cette crise, combinée à des difficultés financières liées à l'absence de renouvellement des achats, a entraîné l'effondrement de sa valeur boursière et la démission en bloc de son conseil d'administration. L'entreprise a déposé le bilan et a finalement été rachetée par la fondation TTAM pour 305 millions de dollars, après une offre concurrente du groupe pharmaceutique Regeneron. Environ 15 % des clients ont demandé la suppression de leur profil ADN à la suite de ces incertitudes sur l'avenir de la base. Cette situation rappelle que lorsqu’une entreprise est rachetée, des incertitudes peuvent apparaître sur l'avenir des données qu'elle récupère.
L'affaire Alibaba : un détournement sans piratage
Un détournement de « l'usage légitime »
En avril 2026, plusieurs médias britanniques révèlent que des données issues de la UK Biobank sont proposées à la vente sur la plateforme chinoise Alibaba. Les fichiers concernent l'intégralité de la base de données, soit les données génétiques de près de 500 000 participants ainsi que les informations de santé et les données sociodémographiques associées.
Contrairement à ce que l'on pourrait penser, l'infrastructure de la UK Biobank n'a pas été victime d'une cyberattaque. Les données avaient été obtenues légalement sous forme de téléchargements par des chercheurs dont les projets avaient été approuvés par le comité scientifique et qui disposaient d'un accès autorisé dans le cadre d'un contrat de mise à disposition.
Une fois copiées sur leurs propres infrastructures, ces données ont fait l'objet de trois annonces de mise en vente sur la plateforme d'Alibaba, en violation des engagements contractuels conclus avec la UK Biobank. Repérées le 20 avril 2026, ces trois annonces ont été supprimées en quelques jours par Alibaba qui a mis en place des filtres automatiques par mots-clés pour bloquer toute future revente et avant qu’une transaction financière n'ait pu être effectuée.
La multiplication des destinataires : un risque structurel
La multiplication des destinataires des données de santé engendre un risque majeur : plus le nombre d’acteurs accédant aux données augmente, plus la sécurité devient difficile à garantir et plus les possibilités de détournement deviennent nombreuses. La sécurité ne dépend pas uniquement de l’infrastructure technique, mais aussi du comportement et des pratiques de sécurité de chaque destinataire. Le niveau de sécurité dépend ainsi de l’acteur le moins vigilant.
Le transfert direct des données à des équipes de recherche internationales accentue ce risque, lorsque les fichiers circulent entre des pays aux règles et aux pratiques de sécurité très différentes. Par ailleurs, plus la chaîne des destinataires s’allonge, plus le lien entre les producteurs des données et leurs utilisateurs réels devient indirect, diluant progressivement le sentiment de responsabilité autour de la protection de ces informations sensibles.
Ce phénomène de dilution et de perte de contrôle rappelle les dérives observées dans l'économie des courtiers en données (data brokers), où des données de géolocalisation collectées par des applications mobiles (par exemple, de jeux mobiles ou de météo) sont agrégées, revendues et diffusées entre une multitude d'acteurs, rendant impossible pour les personnes concernées de savoir qui détient leurs informations ou dans quel but elles sont utilisées. L'enquête du journal Le Monde montre ainsi que des données présentées comme pseudonymes peuvent être réidentifiées en quelques minutes grâce à leur croisement avec d'autres informations (voir aussi le projet Geo Trouve Tous du LINC).
Un mécanisme de dissimulation très simple et les limites du contrôle contractuel
Pour réaliser ce détournement sans déclencher les alertes de la UK Biobank, les auteurs du détournement ont préparé leurs fichiers en leur appliquant la méthode de dissimulation suivante :
- La fragmentation : les bases de données massives ont été découpées en morceaux.
- Le renommage : les codes projets (EID) et les noms des fichiers ont été modifiés.
- Le nettoyage : les métadonnées et toutes les empreintes numériques invisibles ont été effacées.
Cette démarche visait à éviter qu’on remonte aux auteurs. En supprimant la traçabilité immédiate des fichiers, les fraudeurs ont tenté de masquer l'imputabilité du détournement.
Grâce à un e-mail envoyé anonymement par un chercheur basé en Chine, la UK Biobank a pu remonter jusqu'à trois projets menés dans des institutions chinoises. Le rapport d’enquête publié par la UK Biobank a révélé que la fuite provenait de l'Hôpital Xiangya, où un étudiant chercheur non enregistré sur le projet a utilisé les identifiants d'un collègue afin d’extraire et mettre en vente les données sur Alibaba, et de l'Hôpital Tongji, où un employé temporaire non accrédité a accédé à la base de données via le compte d'un chercheur officiel.
Le modèle de sécurité de la base de données montre ici ses limites : même si la plateforme d’origine est bien sécurisée, le contrôle s'affaiblit considérablement dès lors que les données sont exportées sur un système tiers. Aucun mécanisme technique n’empêche leur duplication et leur transmission à des tiers. Pour la plateforme d’hébergement d’origine, il est impossible de s’assurer avec certitude qu’elles restent uniquement accessibles à leur destinataire légitime. Le contrôle repose uniquement sur des engagements contractuels et sur la confiance accordée aux destinataires. Cet incident rappelle donc les risques de mésusages des données personnelles lorsque celles-ci sont principalement protégées par des mesures contractuelles.
Un problème de négligence plus ancien
L'affaire UK Biobank s'inscrit dans une série de précédents liés à la manipulation des données par les chercheurs. Dès 2022, l'organisation constatait que des fragments de données de santé apparaissaient en libre accès sur GitHub, la plateforme de dépôt de code informatique. Dans ce cas, il ne s'agissait pas de chercheurs malintentionnés, mais de scientifiques qui partageaient leur code sans réaliser qu'ils laissaient les données de santé brutes attachées au fichier.
Une étude menée par le chercheur Luc Rocher, de l’Université d’Oxford, démontre l'ampleur de ce phénomène. Entre juillet 2025 et avril 2026, la UK Biobank a dû intervenir à 110 reprises pour demander la suppression de données de participants ainsi laissées en clair sur le web. Les problématiques liées à un téléchargement – parfois exhaustif – des données existaient donc déjà avant l'affaire Alibaba.
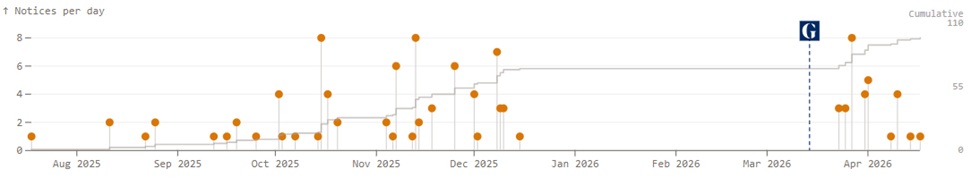
Figure 1 : Chronologie des notifications de retrait (DMCA) émises par la UK Biobank auprès de GitHub. Source : biobank.rocher.lc
Le passage au cloud-only en 2024
Pour stopper les fuites liées aux téléchargements locaux et sécuriser la cohorte, la UK Biobank a imposé le 25 juillet 2024 l'usage obligatoire de sa plateforme cloud, la UKB-RAP, via un investissement de 16 millions de livres sterling avec Amazon Services (AWS). Développé avec DNAnexus (une entreprise américaine spécialisée dans l'analyse et la gestion sécurisée de données génomiques et biomédicales), cet espace virtuel permet aux chercheurs d'analyser les données génétiques et médicales directement sur les serveurs gérés par la UK Biobank plutôt que de récupérer les fichiers sur leur propre ordinateur. Le rapport d’enquête du 1er juin 2026 montre pourtant certaines limites à ce confinement : si le système bloquait l'extraction des données sources, il laissait la possibilité aux chercheurs de télécharger automatiquement le résultat de leurs analyses.
Cette centralisation obligatoire des travaux d’analyse sur les serveurs de UKB a provoqué une résistance chez les neuroscientifiques et spécialistes de l'imagerie médicale. L'analyse de fichiers lourds (comme les IRM du cerveau ou du cœur), auparavant gratuite sur leurs propres outils de calcul, est devenue lourde financièrement sur le cloud payant. La UK Biobank a ainsi dû maintenir une procédure administrative de dérogation autorisant le téléchargement hors cloud (download exemptions). Le Comité de surveillance indique qu'environ 200 institutions internationales ont ainsi conservé le droit d'extraire les données brutes hors du cloud après 2024.
Un autre modèle possible : la plateforme OpenSAFELY
Cette liberté d'extraction met en évidence une différence fondamentale avec la plateforme OpenSAFELY, un modèle alternatif développé par l'Université d'Oxford en 2020 pour répondre à l'urgence du COVID-19 sans exporter ni divulguer les dossiers des patients hors de leurs environnements de stockage sécurisés. Leurs fonctionnements s'opposent à celui de l’UKB-RAP sur deux points majeurs :
- L'accès aux données : sur la UKB-RAP, les chercheurs effectuent leurs analyses en interagissant directement avec les données individuelles des participants. À l'inverse, sur OpenSAFELY, ils ne touchent jamais aux données réelles. Ils travaillent sur des données synthétiques (de « fausses » données qui ont le même format que les données d’origine). Une fois qu'ils ont rédigé les algorithmes permettant de faire leurs analyses statistiques, ce code informatique fait l'objet d'un contrôle préalable pour vérifier qu'il ne contient pas d'instructions suspectes. Ce n'est qu'après validation que le code est transmis sur un serveur sécurisé pour s'exécuter de manière automatisée là où sont stockées les vraies données du NHS.
- Le contrôle des sorties : sur la UK Biobank, le téléchargement des résultats était automatique. À l'inverse, OpenSAFELY impose une procédure de déclaration de sortie avec un double contrôle humain obligatoire : deux personnes vérifient manuellement chaque graphique ou tableau pour s'assurer qu'il ne permet pas de ré-identifier indirectement des individus avant d'en autoriser la sortie.
Le 1er juin 2026, à la suite de la mise en vente des données sur Alibaba, le gouvernement a suspendu l'accès à la UKB-RAP. Parmi les neuf recommandations formulées à cette occasion, la plateforme restera fermée tant qu'un sas de vérification des sorties (Output Checking System), d’abord manuel, ne sera pas déployé. De plus, l’accès aux données de santé issue des dossiers médicaux du NHS restent gelées et des audits forceront la suppression définitive de tous les historiques encore stockés localement par les laboratoires à travers le monde. Le rapport d'enquête de la UK Biobank indique qu'il restait encore 1 200 projets actifs initiés avant 2024 avec des données locales, auxquels s'ajoute l'ensemble des 200 établissements ayant bénéficié des exemptions de téléchargement post-2024.
Réaction publique et risques réels pour les citoyens
Les positions de la direction et des autorités publiques
L’affaire a suscité une couverture médiatique importante au Royaume-Uni, notamment dans le The Guardian et le Financial Times, avant d'être reprise en France par le journal Le Monde. Ce scandale a relancé les débats sur la souveraineté et la protection des données de recherche en santé.
Face aux critiques, le directeur général de la UK Biobank, Rory Collins, dans des propos rapportés par Le Monde, a assuré qu'il ne s'agissait « ni d'une fuite, ni d'une cyberattaque », mais d'un « téléchargement légitime par une organisation légitimement accréditée ». Selon lui, imposer des mesures manuelles ou des contrôles trop contraignants risquerait de ralentir la recherche médicale et la découverte de traitements contre le cancer ou la maladie d'Alzheimer. Dans cette même ligne de défense, la directrice scientifique Naomi Allen a insisté sur la responsabilité exclusive de « chercheurs malveillants » plutôt que sur les risques posés par leur système.
Dans une lettre officielle adressée aux participants le 4 juin 2026, Bernard Taylor, président du comité de surveillance de la UK Biobank, a présenté ses excuses officielles au nom de l'institution, admettant publiquement que la structure « n'avait pas avancé assez vite dans la surveillance de l'utilisation des données par les chercheurs ».
La réaction politique du gouvernement britannique a été immédiate, et d’une teneur assez différente. Qualifiant la sécurité des données au Royaume-Uni de « priorité pour ce gouvernement », le secrétaire d’État à la Technologie britannique, Ian Murray, est intervenu devant le Parlement pour exiger de la UK Biobank la mise en place sans délai d'un nouveau système de contrôle des accès.
L'ADN, une donnée collective et unique
Cette affaire a également nourri une profonde inquiétude au sein de l’opinion publique, entraînant une perte de confiance envers les infrastructures de recherche.
Des participants à la cohorte ont exprimé un sentiment de trahison face à ces défaillances. L'une d'entre elles, une septuagénaire réidentifiée au cours de l'enquête grâce à son seul mois de naissance et la date d'une intervention chirurgicale, a interrogé le respect des engagements pris :« Je suis davantage préoccupée par le respect de l'accord conclu avec les participants. Ils avaient promis de garantir la sécurité de nos données… J'estime que cet élément doit être pris en compte. ».
Les experts interrogés par le The Guardian ont critiqué la réaction de la direction de la UK Biobank, qui suggérait que le risque provenait des informations partagées par les participants eux-mêmes sur Internet. Le professeur Felix Ritchie (Université de l'Ouest de l'Angleterre) s'est indigné de cette position : « Ces gens savent-ils qu’Internet existe ? Il est totalement déraisonnable de penser qu’ils peuvent être certains que leurs bénévoles ne diffuseront jamais d’autres informations les concernant. ».
De son côté, le professeur Niels Peek (Université de Cambridge) a qualifié la fréquence de ces fuites de « choquante », ajoutant que : « L'ampleur et la persistance de ces agissements démontrent les fortes tensions entre l'ambition de mener des recherches en santé à grande échelle grâce aux données et l'impératif juridique et éthique de protéger la vie privée des individus. ».
Comme le souligne le Dr Luc Rocher (Oxford Internet Institute), un simple recoupement de données peut rapidement révéler des éléments extrêmement intimes : « Une fois identifié, ce dossier pourrait révéler des informations sensibles telles qu'un diagnostic psychiatrique, un résultat de test VIH ou des antécédents de toxicomanie ».
Cette crise met en évidence une réalité scientifique et éthique fondamentale : l’ADN et les antécédents de santé ne sont pas des données personnelles classiques, mais des données pluripersonnelles. Un profil génétique n’appartient pas qu'à une seule personne, il est partagé en grande partie avec sa famille biologique. Choisir de partager son patrimoine génétique implique donc la confidentialité médicale de ses proches : en cas de fuite, ce sont aussi les enfants, les parents et les collatéraux des participants qui se retrouvent exposés sur Internet, sans jamais avoir été consultés, ni avoir donné leur consentement.
Le risque de réidentification par croisement de données à l'ère de l'IA
Pour rassurer le public, la direction de la UK Biobank a avancé que les fichiers vendus sur Alibaba « ne contenaient aucune information personnelle identifiante » (comme les noms ou les adresses). Elle a toutefois dû reconnaître que ces profils incluaient le sexe, l’âge, le mois et l’année de naissance, la situation socio-économique ou encore les habitudes de vie des volontaires en plus de toutes les informations de santé liées à chaque individu.
Un billet éditorial publiée en avril 2026 dans la revue médicale The BMJ rappelle que la désidentification ne garantit pas l'anonymat : « dans les jeux de données contenant des attributs démographiques et de santé courants, les dossiers individuels sont souvent uniques et vulnérables à la réidentification, même lorsque ces jeux de données sont incomplets. » (traduction LINC).
Du point de vue du droit de la protection des données, il convient de ne pas confondre pseudonymisation (aussi qualifiée de désidentification) et anonymisation, deux concepts strictement encadrés par le RGPD et précisés par le Comité européen de la protection des données (CEPD / EDPB) :
- La pseudonymisation consiste à remplacer les identifiants directs (nom, prénom, numéro de sécurité sociale) par un code ou pseudonyme. Elle réduit les risques de réidentification directe, mais n'en supprime pas la possibilité si ce code est croisé avec d'autres informations contextuelles. La donnée reste donc une donnée à caractère personnel soumise au RGPD.
- En France, la CNIL (via notamment la méthodologie de référence (MR) 004) l'applique en imposant un pseudonyme unique (ou numéro d’ordre) spécifique et différent par étude pour chaque patient. Seul le responsable de la base initiale conserve la clé de correspondance, ce qui empêche les chercheurs de croiser les données de plusieurs projets.
- L'anonymisation à l'inverse, exige un processus irréversible qui rend impossible toute réidentification de la personne, même par recoupage ou individualisation. Seules les données véritablement anonymisées sortent du champ d'application du RGPD.
Ces bases de données ne se résument pas à du code génétique brut, elles lui associent plusieurs autres variables : tranches d'âge, dates précises de soin, diagnostics hospitaliers ou données géographiques. Avec le développement des bases généalogiques en accès libre, la puissance des algorithmes d'IA et l'accès à des fichiers publics (listes électorales, réseaux sociaux ou fuites de données civiles), ces attributs sociodémographiques deviennent d'autant plus simples à recouper.
Il suffit parfois de ces données annexes pour isoler un profil unique au sein de la base de données. Dès lors que la personne est réidentifiée par le biais de son parcours administratif et médical, c'est l'ensemble de son empreinte génétique qui se retrouve exposé.
En 2025, l'autorité britannique de protection des données (ICO) rappelait (comme d’autres avant elle) que si l'on peut retrouver une identité en recoupant des informations, ces fichiers ne sont pas anonymes et doivent être protégés de façon très stricte.
Les dérives du détournement des finalités
Ce modèle de mise en circulation de ces données ouvre la porte à de nombreux mésusages. Des informations initialement récoltées pour la santé publique se retrouvent détournées vers des objectifs commerciaux, policiers ou idéologiques. Plusieurs risques se matérialisent déjà :
- Lors de l'affaire du CPRD en 2020 au Royaume-Uni, le ministère de la Santé britannique a engrangé 10 millions de livres sterling en vendant des licences d'accès aux dossiers médicaux de millions de patients du NHS à des laboratoires basés aux États-Unis (Merck, Bristol-Myers Squibb, Eli Lilly). Le gouvernement prétendait que ces données étaient anonymes, mais leur niveau de détail permettait de retrouver l'identité des patients. La même année, Amazon a signé un accord de partenariat avec le NHS pour exploiter ces données de santé afin d'entraîner et d'améliorer l'algorithme de son assistant vocal Alexa.
- Aux États-Unis, des compagnies d'assurance-vie utilisent des données de santé ou des scores de risques génétiques pour ajuster leurs tarifs ou refuser des contrats aux personnes prédisposées à certaines maladies. De même, des entreprises de recrutement ont utilisé des informations médicales pour écarter des candidats jugés « à risque » ou moins productifs.
- Lors de l'étude américaine ABCD (Adolescent Brain Cognitive Development) portant sur le développement du cerveau de 20 000 enfants, des chercheurs extrémistes ont récupéré les données médicales pour tenter de produire des recherches pseudo-scientifiques à visée raciste, cherchant à lier génétique et intelligence selon l'ethnie. Ce phénomène s'est étendu à la UK Biobank : le groupe Human Diversity Foundation y aurait accédé pour mener des travaux controversés sur la race et l'intelligence, tandis que la start-up Heliospect Genomics s'en serait servie pour concevoir des outils de sélection d'embryons selon le QI. La Biobank affirme qu'aucune preuve d'utilisation abusive n'a été établie, mais plusieurs généticiens estiment sa réaction trop rapide et dénoncent un manque de contrôle sur l'usage réel des fichiers extraits.
- Des cabinets d'avocats américains ont réussi à utiliser des accès à des réseaux de partage de dossiers médicaux d'hôpitaux pour faire de la prospection de clients. En ciblant des patients ayant des diagnostics précis ou victimes d'erreurs médicales, ils peuvent ainsi les démarcher pour les inciter à attaquer les établissements de soins ou à rejoindre des recours collectifs.
Et en France ?
Et en France ? Entretien avec Marie Zins, Commissaire à la CNIL et ancienne directrice l'Unité de service Inserm « Cohortes épidémiologiques en population »
« La UK Biobank, de par sa taille et la facilité d’accès à ses données, a fait figure de référence au sein de la communauté scientifique et a inspiré de nombreux autres projets. Tous les chercheurs en santé publique connaissent cette base de données. Sa grande politique d’ouverture pour l’accès aux données a permis une large diffusion et de très nombreuses réutilisations. L’incident relaté ici questionne la pertinence de ce modèle.
En tant que chercheurs, nous avons une responsabilité morale vis-à-vis des personnes qui acceptent de nous faire confiance en partageant leurs données pour la recherche. A l’Inserm, j’ai travaillé pendant de nombreuses années sur les cohortes Constances (220 000 participants) et Gazel (20 000 volontaires), dont j’avais la responsabilité. J’ai pu constater les évolutions des pratiques de recherche et du partage des données. Au départ, les données étaient partagées directement avec des chercheurs qui en avaient besoin pour leurs projets de recherche. Une part significative de notre travail consistait à faire le suivi des projets et en particulier s’assurer que les données étaient bien détruites après la fin du travail de recherche. Mais lorsque les données circulent et peuvent être recopiées, il est très difficile de s’assurer que chaque copie a bien été détruite.
Au fil du temps, nous sommes passés du partage direct des données à une mise à disposition des données sur une plateforme sécurisée dont nous avions le contrôle. Sur ces infrastructures, les extractions de données ne sont pas permises. Nous avons demandé que chaque export soit vérifié manuellement pour s’assurer qu’il ne comporte pas de données personnelles. Le risque d’incident tels que celui de la UK Biobank est fortement réduit. De plus, le système enregistre toutes les analyses faites par les utilisateurs, ce qui permet des vérifications en cas de doutes sur le bon usage des données.
Il faut avoir conscience que la gestion d’une infrastructure d’accès sécurisé à des données est un métier à part entière. Il nécessite des ressources et des connaissances spécialisées. C’est pourquoi il est souvent plus vertueux de mutualiser ces projets sur une plateforme partagée, plutôt que chacun essaie de sécuriser ses propres données, sans avoir la taille critique pour maintenir son système à l’état de l’art. De la même manière, il faut battre en brèche l’idée que ces plateformes d’accès sécurisé ne sont pas adaptées à la recherche car elles ne proposeraient pas les tous les outils d’analyses nécessaires aux chercheurs, en particulier pour des recherches souhaitant recourir à des outils d’intelligence artificielle. Cela ne me semble pas correct : il est tout à fait possible de créer des espaces dans lesquels ces outils sont importés – après un contrôle préalable pour s’assurer qu’ils ne représentent pas un risque pour la sécurité – avec des infrastructures qui s’adaptent rapidement aux besoins exprimés par les chercheurs. Pour parler de mon expérience, nous avons travaillé avec le Centre d’accès sécurisé aux données (CASD), qui couvre tous ces besoins tout apportant d’excellente garantie sur la protection des données. L’arrivée prochaine de l’Espace européen de données de santé pose la question du modèle d’accès aux données que nous souhaitons, et je pense qu’il faut continuer à aller dans ce sens. »
Marie Zins
Marie Zins est docteur en médecine et en épidémiologie, titulaire d’une habilitation à diriger les recherches. Elle a été directrice de l'Unité de service Inserm "Cohortes épidémiologiques en population » et responsable de deux cohortes appariées au Système national des données de santé (SNDS) et aux bases de l’Assurance vieillesse : l’Infrastructure Nationale Constances, qui avec 220 000 participants représente le plus important projet de recherche d'épidémiologie et de santé publique en France, et la cohorte Gazel (20 000 volontaires suivis depuis plus de 35 ans). Elle est membre de la CNIL depuis février 2024
L’accès aux données de santé pour la recherche est organisé, par conception, dans des systèmes centralisés permettant d’exploiter les données sans les exporter. La base nationale du SNDS respecte un référentiel de sécurité qui s’étend à tous ses systèmes-fils, dont le Health Data Hub ; les entrepôts de données hospitaliers ont été encadrés par la CNIL sur une exigence d’accès aux données dans des espaces sécurisés et supervisés, qui s’applique aussi aux éventuels partenaires recevant exceptionnellement une copie des données ; les exports de données par les chercheurs sont limités à des résultats dont l’anonymisation est contrôlée au préalable ; les projets de recherche sont soumis à l’approbation d’un comité de gouvernance et/ou d’un comité d’éthique.
Même si cela peut sembler contraignant pour les chercheurs, ce niveau d’exigence répond au constat que les données de santé, même pseudonymisées, sont tellement riches et liées au parcours individuel d’un patient qu’elles présentent par nature un risque élevé de réidentification et d’exploitation à des fins malveillantes. Contrôler leur circulation et surveiller activement leur usage est donc indispensable pour protéger les droits, et conserver la confiance, des citoyens et des participants aux projets de recherche.
A l’heure où le nouveau règlement pour l’espace européen des données de santé se propose de définir les conditions de circulation et d’accès aux données des citoyens européens pour le soin et la recherche, dans un contexte de violations massives de données de santé, il apparaît plus que nécessaire de s’appuyer sur ces principes éprouvés de protection des données dès la conception.