

Cette deuxième partie prolonge l’exploration amorcée précédemment sur la fabrique d’IA en open source. La première partie s’intéressait à ce que signifie l’ouverture dans ce cadre précis : elle montrait comment l’open source s’impose aujourd’hui comme un mode de production industriel à part entière, tout en étant structuré par des contraintes matérielles, juridiques et économiques particulières. Les plateformes comme Hugging Face en constituent le principal terrain d’observation, à la fois infrastructure technique, espace de coordination et acteur du secteur.
Nous abordons ici la seconde dimension de cette enquête : ce que “fabriquer” veut dire dans ce contexte. L’enjeu n’est plus de comprendre les principes de l’ouverture, mais d’observer concrètement comment le travail s’organise et se distribue dans ce mode de production. À partir des données disponibles sur Hugging Face, cette partie s’intéresse à la généalogie des modèles (les chaînes de reprises et de dépendances entre versions), à la division du travail, et aux formes de spécialisation qui se dessinent selon les modèles, les organisations et les ressources mobilisées.
Autrement dit, il s’agit de suivre le travail là où il se donne à voir : dans les opérations de reprise, d’adaptation et de transformation qui relient les modèles entre eux. Derrière les discours d’ouverture et de collaboration, il est possible de découvrir ainsi une production distribuée, inégalement répartie, où les conditions matérielles et la taille des modèles semblent influencer les formes de participation et de coopération.
La création d’un modèle d’IA n’est pas une entreprise individuelle. Chaque modèle s’appuie sur le travail d’autres, qu’il reprend, adapte ou simplifie. La production se fait par enchaînements : entraînements, ajustements, mises à disposition. Même lors de l’entraînement d’un modèle de fondation, il n’est pas rare de prendre comme point de départ un modèle performant pré-existant. Ces reprises multiples dessinent un type de division du travail où certains conçoivent des modèles de base, tandis que d’autres assurent leur adaptation ou leur diffusion. Les généalogies de modèles rendent visibles cette production distribuée.
Sur Hugging Face, ces liens de filiation sont en partie formalisés. La plateforme propose des champs d’information permettant d’indiquer le modèle de base à partir duquel une version dérivée a été produite (voir Encadré 2). Ces métadonnées ne sont cependant renseignées que dans environ 30 % des cas, ce qui suggère que de nombreuses relations de dépendance restent implicites.
Encadré - Liens entre modèle cible et modèle source HuggingFace propose quatre types de liens entre le modèle cible et la source lorsqu’il faut remplir la fiche d’information d’un nouveau modèle. Ajustement (finetune) : le modèle cible est obtenu par réentraînement du modèle source sur un jeu de données spécifique afin de le rendre performant pour une tâche précise. Quantisation (quantized) : le modèle cible est obtenu en réduisant la précision des poids du modèle source afin de réduire son empreinte en mémoire. Adaptation (adapter) : le modèle cible est obtenu par une méthode d’ajustement particulière qui nécessite peu de ressources de calcul. Fusion (merge) : le modèle cible est obtenu par une méthode qui combine des couches issues de plusieurs modèles sources afin d’améliorer leurs performances. |
Le graphique ci-dessous montre l’évolution mensuelle des types de relations déclarées entre les modèles. Les opérations d’adaptation (adapter) dominent à certains moments, notamment lorsqu’un modèle phare suscite un effort collectif d’appropriation – par exemple, pour des modèles comme DeepSeek R1, largement repris dès leur mise à disposition. En toile de fond, les transformations de type finetune et quantize demeurent présentes et relativement stables.
Figure 1 : Evolution mensuelle des liens entres modèles (2022-2025)
Ces relations de dépendance créent de véritables généalogies techniques. Le graphe relationnel ci-dessous permet d’en observer la structure : il est possible de distinguer de grands ensembles de modèles dérivés, organisés autour de quelques nœuds centraux. Certains modèles de base (comme Llama ou Mistral) agissent comme des points de passage obligés, à partir desquels se déploient de multiples versions adaptées, compressées ou spécialisées. Ce point de vue relationnel (figure 2) met en évidence les interdépendances sociotechniques entre modèles, acteurs et types d’opérations, et rend visible une production distribuée.
Figure 2 : Graphe des interdépendances partant du modèle SmolLM2-1.7B-Instruct de Hugging Face (appuyer sur le bouton triangle)
Ces premières observations amènent d’autres questions, plus larges : comment s’organise cette distribution du travail ? Quels rôles prennent les différents acteurs dans cette chaîne de production ouverte ?
L’analyse des généalogies de modèles met en évidence des différences nettes dans la manière dont le travail de production se distribue autour des modèles de base. Empiriquement, ces différences sont visibles dans la structure topologique des réseaux de dérivations. Dans le cas de Llama de Meta (figure 3), il est possible d’observer une structure ramifiée, avec plusieurs grappes périphériques alimentées par d’autres acteurs que Meta, parfois connectées entre elles. Les chaînes de dérivations successives peuvent être assez longues, au cours desquelles plusieurs acteurs se relaient. À l’inverse, Mistral se caractérise par une structure beaucoup plus centralisée (figure 4). La majorité des dérivations se rattachent directement au modèle de base, et les chaînes de reprise sont plus courtes. Les sous-communautés animées par d’autres acteurs sont plus rares et faiblement connectées entre elles, ce qui traduit une dynamique de réutilisation bien plus resserrée autour de Mistral. Ces contrastes suggèrent que derrière une apparente homogénéité du modèle open source se déploient des régimes de production différenciés, où la circulation du travail, la place du modèle de base et le degré d’autonomie des contributeurs varient fortement selon les configurations.
Figure 3 : Graphe des interdépendances partant du modèle Mistral-7B-Instruct-v0.1 de Mistral (appuyer sur le bouton triangle)
Figure 4 : Graphe des interdépendances partant du modèle Llama-3.1-8B-Instruct de Meta (appuyer sur le bouton triangle)
La comparaison entre des modèles de taille équivalente (autour de sept milliards de paramètres) confirme ces variations dans la distribution du travail. Certains écosystèmes se structurent autour d’un centre unique et très dense, tandis que d’autres présentent plusieurs foyers de transformation secondaires. La figure 5 montre le nombre de modèles situés à une distance d du modèle de base, met en évidence ces différences : chez certains acteurs comme Qwen ou Mistral, le nombre de dérivations diminue au fur et à mesure de l’éloignement du modèle initial, traduisant une dynamique principalement centripète. À l’inverse, chez Meta, il est possible d’observer une réactivation périphérique : le nombre de modèles dérivés augmente à une certaine distance avant de décroître à nouveau, ce qui suggère que de nouveaux points de transformation émergeant au-delà du noyau initial.
Figure 5 : Nombre de modèles en fonction de la distance au modèle initial
La comparaison intra-famille permet enfin de formuler une hypothèse quant au rôle des contraintes matérielles sur la division du travail : en maintenant constante la famille de modèles (par exemple, la famille llama-3.1-Instruct produite par Meta), mais en faisant varier le nombre de paramètres, la topologie de la généalogie et le nombre d’acteurs impliqués, la topologie change sensiblement. Sur le premier graphe (le modèle le plus petit du triptyque), il est possible de distinguer un noyau central entouré d’un grand nombre de dérivations et de sous-centres secondaires, avec des chaînes longues et plusieurs reprises latérales. Sur le second (taille intermédiaire), les grappes périphériques subsistent, mais sont moins développées ; les chaînes se raccourcissent et la production se concentre davantage autour de quelques relais. Sur le troisième (modèle le plus volumineux), la figure se resserre en étoile clairsemée : peu d’auteurs, peu de branches, une ou deux séquences de dérivation dominantes et presque aucune circulation entre les dérivés. Autrement dit, il semble qu’à mesure que le coût de manipulation augmente, la production se recentre sur un petit nombre d’acteurs capables d’assumer ces opérations.
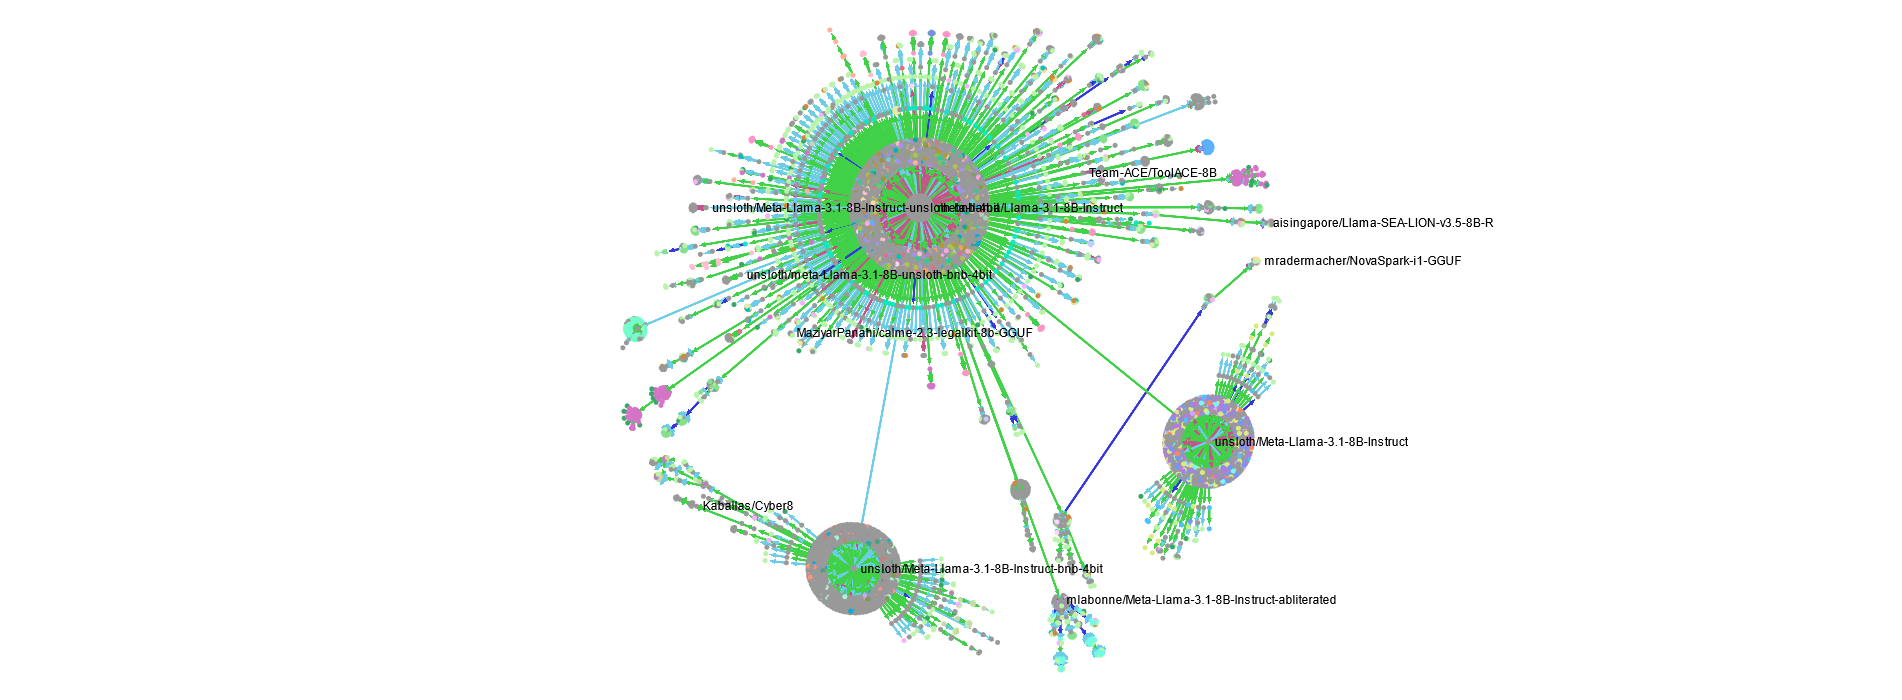
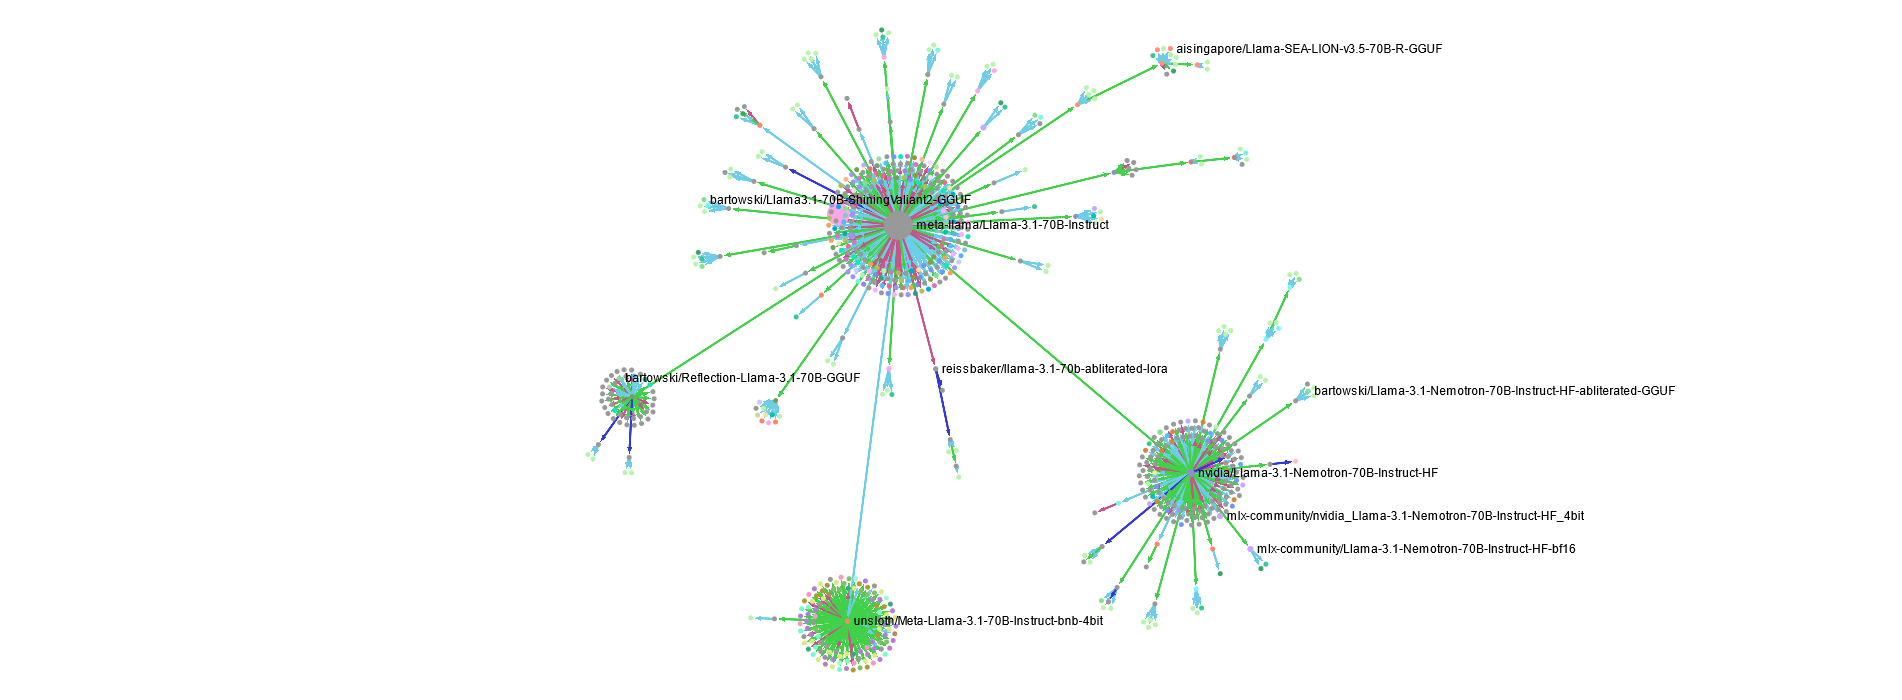
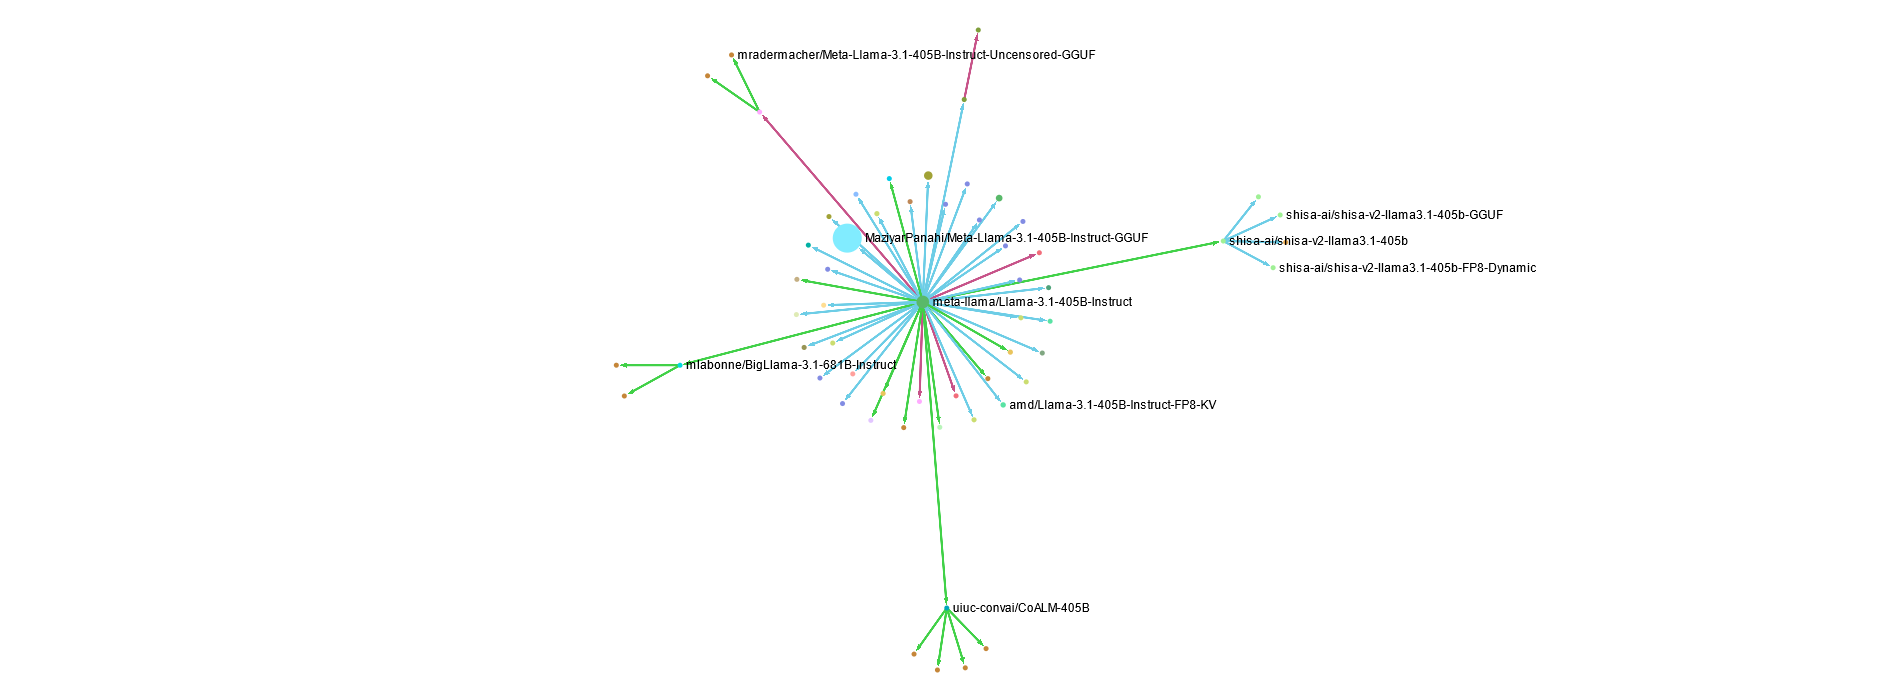
Figure 6 : Comparaison des interdépendances pour les modèles de la famille Llama-3.1-Instruct par nombre de paramètres : 8B (haut), 70B (milieux), 405B (bas)
L’analyse des publications associées aux principales familles de modèles, Llama, Mistral et Qwen, met, quant à elle, en évidence une division du travail structurée par type d’opération. En effet, de nombreux contributeurs n’interviennent que sur un seul geste technique ou reproduisent toujours la même chaîne opératoire.
Figure 7 : Répartition des types de liens par auteurs dans la généalogie des modèles Llama de Meta
La Figure 7, qui présente quatre variantes de Llama (3.1-8B-Instruct, 3.1-70B-Instruct, 3.2-1B-Instruct et 3.2-3B-Instruct), illustre nettement ce phénomène. Chez Llama-3.2, par exemple, JesseLiu domine le volume de publications et se consacre presque exclusivement à l’adaptation, avec 38 publications sur le modèle 1B et 55 sur le 3B. QuantFactory se spécialise dans la quantization, avec 7 publications sur le 1B et 14 sur le 3B, tandis que HappyAIUser est identifié principalement au finetuning, avec 20 publications sur le 3B. Ces profils mettent en évidence une répartition claire des rôles techniques.
Cette logique de spécialisation est déjà visible sur des modèles plus petits comme le Llama-3.1-8B-Instruct, avec des auteurs comme unsloth, actif surtout sur la quantization avec quelques publications en finetune, ou encore robust-rlhf et NikolaSigmoid, qui restent chacun limités à un ou deux gestes. À l’autre extrémité, le Llama-3.1-70B-Instruct attire moins de contributeurs et concentre les publications sur un petit noyau d’auteurs spécialisés dans le finetune ou le quantized, ce qui suggère que seuls certains auteurs ont à la fois la volonté et les ressources de travailler sur ces modèles.
Une autre observation importante est qu’une même chaîne opératoire est rarement menée par un seul acteur. Peu de contributeurs enchaînent plusieurs transformations, par exemple un finetune suivi d’une quantization, sur un même modèle. Le travail publié est donc le plus souvent fragmenté, chaque auteur occupant une position identifiable dans la chaîne de transformations (l’un finetune, l’autre adapte, un dernier quantize). Les opérations de type merge ou classées comme inconnue restent marginales sur l’ensemble des modèles étudiés. Certains contributeurs se spécialisent non seulement dans une opération donnée mais aussi dans son application à des modèles issus d’une organisation particulière. Ainsi, NikolaSigmoid concentre son activité sur le fine tuning de modèles produits par une seule organisation, unsloth (figure 8).
Figure 8 : Origine des modèles publiés par l’utilisateur NikolaSigmoid
Il faut souligner ici une limite de cette analyse : la nomenclature utilisée, qui regroupe le travail sous de grandes catégories comme finetune ou adapter, masque sans doute des différenciations internes. Il existe probablement plusieurs manières de finetuner ou d’adapter un modèle, mobilisant des savoir-faire, des outils et des ressources différents. Ces variations demeurent invisibles dans le cadre analytique actuel et constituent une piste pour de futures enquêtes visant à mieux appréhender les degrés de spécialisation du travail informatique.
Derrière la circulation apparente des modèles sur Hugging Face, se trouvent des formes d’organisation collective hétérogènes. Certains ensembles semblent même se comporter comme de véritables pôles de production, où les mêmes auteurs se retrouvent autour de variantes proches. Ces contrastes dessinent une géographie du travail distribuée, faite d’archipels plus ou moins connectés.
La Figure 9 représente la matrice d’intersection qui, pour chaque paire de modèles, représente le nombre d’auteurs présents dans leurs généalogies respectives. Il est possible d’observer des « amas » plus clairs par sous-famille : des blocs autour de variantes proches (par exemple au sein de Llama 3.x, de Qwen 2.x ou de Mistral 7B/8x7B) indiquent que les mêmes auteurs reviennent d’un modèle à l’autre. À l’inverse, de larges zones sombres entre familles traduisent peu d’intersections : les collectifs qui travaillent sur Qwen se recoupent rarement avec ceux de Llama ou de Mistral, et réciproquement. La densité semble plus élevée entre des modèles de taille et de profil voisins (instruct, mêmes ordres de grandeur en paramètres). Au total, les acteurs se rassemblent autour des mêmes modèles et de leurs déclinaisons, formant des groupes relativement stables, tandis que les passages entre familles restent limités.
Figure 9 : Matrice d’intersection des auteurs présents dans la descendance de certains modèles
Ces observations suggèrent que le mode de production ouvert des IA n’est pas uniformément réparti entre des acteurs parfaitement égaux. Au contraire, ils permettent d’entrevoir une organisation sociale du travail technique, où des gestes particuliers comme le finetune, la quantization ou l’adaptation deviennent des spécialisations à part entière. Il serait utile de mesurer plus systématiquement le degré de spécialisation des contributeurs selon les familles et tailles de modèles. Il reste également à comprendre selon quels critères cette division du travail opère : est-elle le fruit de préférences et d’intérêts différenciés, de compétences individuelles inégales, de contraintes logicielles ou matérielles, ou de stratégies individuelles par lesquelles les contributeurs doivent trouver leur place dans une division du travail déjà stabilisée, entre imitation et recherche de distinction ?
Cette première exploration de la plateforme Hugging Face met en évidence plusieurs pistes de réflexion sur la fabrique des IA dites « open source ». D’abord, l’analyse suggère que l’open source dans l’IA s’inscrit dans une continuité avec les dynamiques industrielles actuelles, plutôt qu’en rupture avec elles : loin de l’idéal d’autonomie du logiciel libre, il apparaît aligné avec intérêts du secteur. Ensuite, l’ouverture est contrôlée et sélective. Elle se concentre avant tout sur la possibilité de dérivation des modèles, tandis que les données ou le code d’entraînement demeurent, dans l’ensemble, inaccessibles. L’examen des généalogies de modèles met par ailleurs en lumière une production distribuée mais hétérogène : certaines familles de modèles, comme Llama, semblent favoriser un écosystème d’acteurs secondaires relativement importants, tandis que d’autres, comme Mistral ou Qwen, restent centraux dans leurs écosystèmes et jouent le rôle des points de passage obligés. Cette hétérogénéité s’exprime aussi dans la spécialisation technique des acteurs individuels dans certaines opérations de dérivation (finetune, quantization ou adaptation). La contrainte matérielle semble, de son côté, accentuer les inégalités entre des acteurs inégalement dotés en ressources computationnelles : plus les modèles sont volumineux, plus le travail tend à se concentrer entre quelques acteurs disposant de la puissance de calcul nécessaire. Enfin, la cartographie des collaborations met en évidence une organisation en archipels relativement isolés, ce qui suggère que les acteurs ne s’intéressent pas à tous les modèles, mais se concentrent sur une ou plusieurs familles. Ces résultats restent, à ce stade, exploratoires : ils appellent des investigations complémentaires pour préciser les formes sociales, techniques et économiques de la fabrique des IA open source.