

La récente levée de fonds de Mistral, largement mise en avant dans les médias français, rappelle que l’open source demeure un mode de production stratégique dans l’industrie de l’intelligence artificielle. Même si le « champion français » s’est départi du tout open source, cette approche demeure une composante essentielle de son modèle d’affaires, comme c’est aussi le cas pour d’autres acteurs majeurs du secteur, comme Meta. Si le débat public se concentre sur les IA propriétaires (OpenAI, Anthropic ou Google DeepMind), qui fournissent les services commerciaux les plus utilisés, une part importante de la création de modèles s’organise aujourd’hui selon un autre principe : la production en open source.
Derrière la promesse d’autonomie associée aux IA, soi-disant capables de remplacer ou d’imiter certaines activités humaines, se cache en effet une forte intensité de travail humain : annotation, curation, entraînement, documentation. L’attention se porte ici sur le travail collectif des informaticien·nes et des expert·es en IA qui conçoivent, adaptent et partagent les modèles, au cœur de cette production dite “ouverte”.
Pour l’observer, nous nous appuyons sur les données publiques de Hugging Face, plateforme de production et de circulation des modèles d’IA.
Cet article, en deux parties, propose une première exploration empirique de ces données. L’objectif est de mieux comprendre comment s’organise la production des IA sur cette plateforme, entre conditions matérielles, division du travail et cadres juridiques. Son but n’est pas de fournir des résultats définitifs, mais plutôt de formuler des questions et des hypothèses à partir d’une analyse quantitative de ces données.
L’analyse se déploie en deux temps. Cette première partie s’attache à éclairer ce qu’ouvrir signifie dans le contexte de Hugging Face. La seconde partie portera plus directement sur la division et l’organisation du travail qui soutiennent la fabrique des IA dites “ouvertes”. Enfin, nous proposons en annexe du premier article une description de notre méthodologie d’analyse de données.
Encadré - Définitions et cadrage IA, un terme parapluie et pluriel : expression qui agit comme un « terme parapluie désignant un ensemble de technologies faiblement liées » (Narayanan et Kapoor, 2024). Swanson (1988) parle de technologies visant à « faire accomplir aux ordinateurs des actions semblables à celles des humains ». Il n’existe donc pas une IA mais une pluralité d’IA, multiples et hétérogènes, produites et déployées dans des contextes techniques et organisationnels variés. « Open source » : mode de production logiciel qui remonte au logiciel libre des années 1980. Relativement invisible pour le grand public, c’est un mode de production essentiel à l’industrie informatique (selon des estimations, 97% des applications commerciales utilisent des logiciels libres ou open source). Traditionnellement associé aux infrastructures et à la maintenance, sa traduction dans le monde des IA pose de nouvelles questions. |
Avant de plonger dans l’exploration des données, commençons par un bref retour sur l’histoire de Hugging Face. Comment cette start-up américaine, fondée par des ingénieurs français en 2016, a-t-elle développé sa plateforme ?
Le premier produit de l’entreprise est un chatbot destiné à être un « ami » pour les adolescents. C’est au cours de ce développement que l’entreprise a décidé de mettre à disposition en open source certaines briques logicielles et algorithmiques qui avaient été nécessaires. À une époque où les modèles de langage sont encore balbutiants, et où il est souvent très compliqué de s’en servir, cette ouverture a attiré l’attention d’industriels et de chercheurs. Suite à cela, les fondateurs décident d’orienter le développement d’Hugging Face vers la mise à disposition d’outils et de modèles d’IA open source.
Ce changement de vision intervient concomitamment avec la mise à disposition par Google des poids du modèle BeRT (Bidirectional Encoder Representations from Transformers). La librairie open source d’Hugging Face Transformers est publiée en décembre 2018 et a débuté comme une réimplémentation en PyTorch (une librairie très populaire pour l’apprentissage profond) de BeRT, et est rapidement devenue un projet communautaire pouvant s’adapter à des douzaines d’architectures de modèles (Wolf et. al. 2019). À la mi-2019, le repo Github de la librairie est devenu extrêmement populaire, et a permis de fédérer un ensemble d’acteurs voulant utiliser, ou modifier, le modèle de Google.
Hugging Face développe par la suite “le Hub” : une plateforme permettant de partager facilement des modèles, au départ, principalement des modifications de BeRT. Ainsi, cinq ans après sa publication et malgré l’essor fulgurant des LLMs open source des trois dernières années, BeRT demeure le modèle le plus téléchargé sur la plateforme (figure 1), et le nombre de modifications opérées par des utilisateurs de Hugging Face puis téléversées sur la plateforme est en constante augmentation (figure 2).
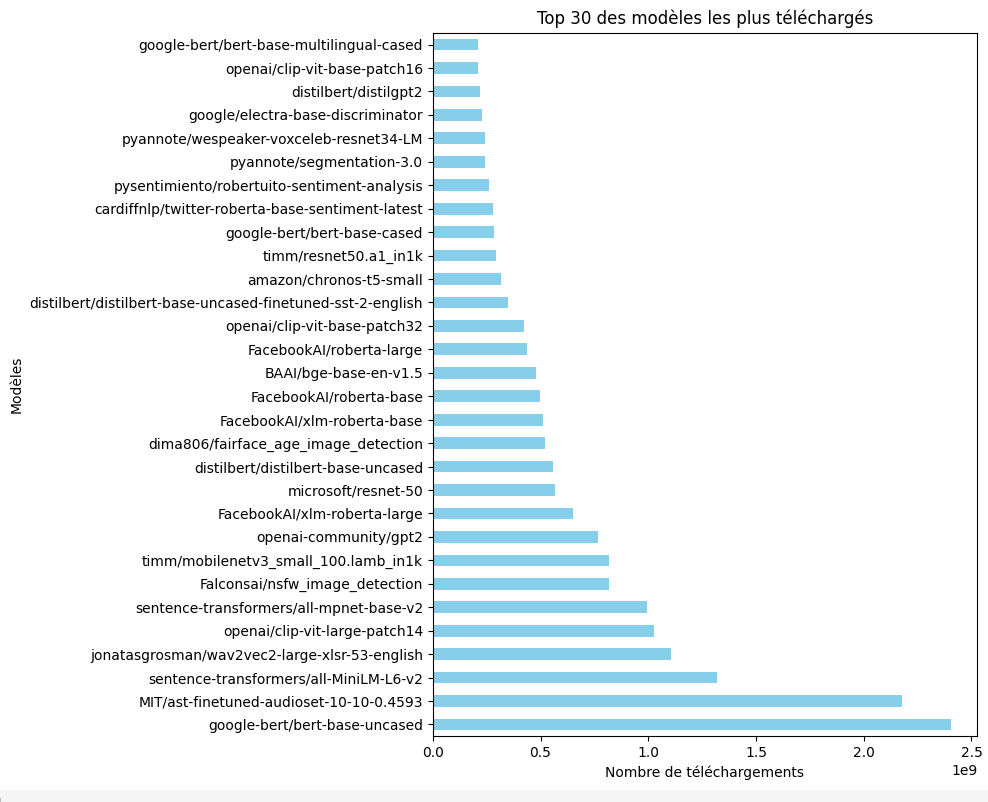
Figure 1 : Top 30 des modèles les plus téléchargés sur Hugging Face
Figure 2 : Nombre de descendants du modèle bert-base-uncased au cours du temps
Venons-en maintenant à l’exploration de cette base de données. Première constatation : l’ensemble du travail nécessaire à la production de l’intelligence artificielle n’est pas uniformément représenté sur Hugging Face. La plateforme héberge environ deux millions de modèles contre cinq cent mille datasets (cf figure 2), et à peine 6,95 % des modèles déclarent le dataset utilisé. Cela suggère que le travail rendu public et organisé via ce mode de production porte surtout sur les modèles, tandis que le travail lié aux données est largement délégué ou maintenu hors de la plateforme.
Figure 3 : Nombre de modèles et datasets présents sur HF au cours du temps
Plusieurs hypothèses peuvent être avancées pour expliquer cette surreprésentation des modèles par rapport aux données. Elle tient d’abord à l’histoire même de Hugging Face, pensée dès l’origine comme un espace de partage et de réutilisation de modèles, alors que les grands jeux de données communs de l’industrie, comme CommonCrawl, se sont constitués ailleurs. Cette trajectoire a pu façonner le type de travail encouragé et facilité par la plateforme : l’adaptation et la réutilisation de modèles.
Une autre hypothèse est liée au coût humain de la production de données. La constitution et la maintenance de datasets requièrent un travail considérable de curation, de documentation et souvent d’annotation, réalisé par des prestataires ou des personnes contribuant de manière invisible, en particulier dans des pays du Sud global (Irani, 2015). À l’inverse, publier ou affiner un modèle est moins intensif en main-d’œuvre et s’intègre plus facilement aux outils de versionnage et de collaboration proposés par la plateforme.
Enfin, les enjeux juridiques et stratégiques jouent sans doute un rôle décisif. Les datasets constituent un actif important dans la création de valeur et l’obtention d’un avantage compétitif ; leur ouverture expose les acteurs à des risques liés au droit d’auteur, à la protection des données personnelles ou à la concurrence. Cette incertitude contribue à maintenir le travail sur les données en dehors du mode de production ouvert, et donc de la visibilité et de la traçabilité offertes par une plateforme comme Hugging Face.
Cette répartition reflète un couplage fort avec le reste de l’industrie : la production open source de l’IA ne constitue pas un espace radicalement autonome ou indépendant, mais illustre en partie les hiérarchies et les contraintes connues de ce secteur. Cette dynamique de production différenciée ne disparaît pas lorsqu’on s’en tient aux modèles.
L’examen des téléchargements cumulés des modèles par famille de tâches sur Hugging Face (figure 4) montre que le Natural Language Processing (NLP), qui inclut aujourd’hui la plupart des grands modèles de langage (LLM), reste la famille dominante sur toute la période 2022–2025. Sa courbe est la plus élevée et croît de manière relativement régulière, avec quelques accélérations visibles fin 2023 et mi-2024, suivies d’un ralentissement du rythme de croissance depuis fin 2024. La deuxième famille, Computer Vision, est loin derrière, avec une progression stable mais bien plus lente, et ne réduit pas l’écart. La catégorie Other est hétérogène (par exemple, graph machine learning), tandis que la catégorie Unknown (non représentée sur le graphe) regroupe tous les modèles sans tâche déclarée — près de 1,3 million sur les deux millions présents sur la plateforme —, ce qui limite la précision des répartitions.
Figure 4 : Somme cumulée des téléchargement par famille de modèles
Cette configuration met en évidence une concentration durable du travail rendu public sur les LLM, et s’inscrit encore une fois dans la continuité des tendances du secteur depuis la sortie et le succès de ChatGPT en novembre 2022.
Cette continuité contraste avec le logiciel libre traditionnel. En effet, la majorité des contributions porte sur des outils, des bibliothèques et des infrastructures utiles aux programmeurs et à l’industrie informatique, à la différence de l’informatique commerciale, davantage axée sur la conception de produits et services à destination des entreprises et des particuliers. À l’inverse, dans l’IA en open source, le travail ouvert s’organise prioritairement autour des familles les plus visibles et les plus porteuses dans l’industrie dans, l’état actuel de son développement, en particulier le NLP et les LLM. Cela indique à nouveau un fort couplage entre la production ouverte et les tendances perceptibles sur la chaîne de valeur.
Cette concentration du travail à ce stade sur certaines familles de modèles ouvre sur une question plus large : quelle forme spécifique prend le mode de production ouvert dans l’IA, et comment les cadres techniques et juridiques (licences, infrastructures, pratiques de réutilisation) orientent-ils la distribution des tâches et des responsabilités entre acteurs ?
L’analyse des licences déclarées sur Hugging Face (figure 5) montre que la catégorie « open source » recouvre en réalité des situations très diverses. Le graphique ci-dessus présente l’évolution mensuelle des types de licences associées aux modèles publiés depuis 2022. La licence Apache 2.0 domine largement, avec une forte croissance à partir de 2023, un pic au début de l’année 2025, puis un léger repli. Derrière, on trouve des licences comme CC-BY 4.0 ou CC-BY-NC 4.0, dont la présence reste importante mais secondaire. Les licences de type GPL, historiquement centrales au sein du logiciel libre, sont quasi absentes. Apparue en 2004, la licence Apache 2.0 s’inscrit dans le tournant « open source » de la fin des années 1990, pensée pour faciliter l’adoption par les grandes entreprises, là où la GPL, élaborée dans les années 1980 comme instrument de copyleft du logiciel libre, vise à rendre irréversible la mise en commun en imposant la réouverture des dérivés. Sur Hugging Face, la distribution générale suggère une préférence nette pour des régimes de partage permettant le réemploi commercial.
Cette tendance confirme que la production d’IA open source s’inscrit dans une économie différente de celle du logiciel libre traditionnel. En comparant ces résultats à ceux observés pour les projets open source hébergés sur GitHub, le contraste est frappant. En effet, puisque le logiciel libre s’est construit sur des licences dites « contaminantes » (le réemploi du code est permis à condition d’employer une licence libre) dans les années 1980, ces dernières restent parmi les plus utilisées (3ème ou 4ème position). À l’inverse, ces licences sont presque absentes sur HuggingFace, les modèles privilégiant largement les licences qui autorisent la réutilisation dans un régime juridique propriétaire et fermé. Plusieurs grands acteurs, comme Meta, ont cependant adopté des licences spécifiques qui restreignent certains usages commerciaux, créant ainsi des zones d’incertitude juridique pour les entreprises souhaitant réutiliser ces modèles. Ces choix de licences témoignent, à nouveau, d’un fort couplage entre l’open source de l’IA et les logiques industrielles actuelles.
Figure 5 : évolution mensuelle des licences des modèles publiés (2022-2025)
L’appellation « open source » appliquée à l’IA fait d’ailleurs débat. Widder, Whittaker et West (2024) parlent même d’« openwashing » : le plus souvent, seuls les poids des modèles (les artefacts informatiques permettant d’utiliser un modèle par soi-même) sont rendus publics, tandis que les données ou le code d’entraînement ne sont pas communiqués. Même si cela était le cas, les infrastructures massives de calcul nécessaires à la reproduction de ces modèles limiteraient grandement l’ouverture et le réemploi effectifs. Certains auteurs voient dans l’open source un enjeu de pouvoir logistique, conférant aux entreprises la capacité d’imposer des standards techniques, d’organiser la circulation des ressources et de gouverner les infrastructures (Zhang et Carpano, 2023) et ainsi d’organiser la concurrence sur le marché à leur profit. L’open source peut ainsi être compris comme un « bien industriel public » (Alcaras, 2020), c’est-à-dire une organisation du travail et des rapports de production qui, bien que différentes du paradigme propriétaire classique, s’inscrivent dans des logiques industrielles et productives plus larges.
Au terme de cette première exploration de la plateforme Hugging Face, nous pouvons faire l’hypothèse que l’IA open source représente l’aboutissement d’un mouvement amorcé depuis au moins dix ans dans le secteur logiciel, à savoir un couplage bien plus étroit et explicite de l’open source avec le reste de l’industrie, au détriment de l’autonomie propre de l’open source. Cela s’observe notamment dans le fait que la production d’IA en open source suit les grands intérêts du secteur (effervescence autour des LLMS et du NLP; secret autour des données d’entraînement), tout en se détachant des intérêts qui sont, historiquement, ceux du logiciel libre (licences de type GPL ; accès complet au code). Cela ne signifie pas pour autant qu’il n’existe aucune différence entre les IA propriétaires et celles hébergées sur Hugging Face. La mise à disposition des poids des modèles permet en effet à des personnes ou des organisations d’opérer des modifications sur ces modèles, par exemple à l’aide de nouvelles données, puis éventuellement de remettre le résultat de cette modification à disposition sur Hugging Face. Ces modifications pouvant être enchaînées, cela donne naissance à une forme spécifique d’organisation du travail dans la production de modèles d’IA : un modèle open source peut donner naissance à toute une série d’autres, et ainsi de suite…jusqu’à former une généalogie.
Dans la seconde partie de cet article, nous approfondirons l’étude de la structure des généalogies des modèles et la division du travail dans la production d’IA en open source qu’elles permettent de mettre au jour. Nous examinerons comment les acteurs se répartissent les rôles dans cette production distribuée : qui s’occupe de l’adaptation, de l’entraînement ou de la quantization des modèles ? Comment cette division varie-t-elle selon la taille des modèles, leur famille ou les ressources matérielles disponibles ? Ces questions nous permettront d’entrer plus en détail dans les pratiques collaboratives de la fabrique des IA sur Hugging Face.
La plateforme Hugging Face met à disposition une base de données référençant :
chaque modèle téléversé sur la plateforme :
son nom,
son auteur (qui peut être une organisation ou une personne physique),
des caractéristiques concernant le modèle (nombre de paramètres, type de fonctionnalités) dont certaines sont déclaratives (informations concernant les données d’entraînement, liens de transformation depuis d’autres modèles, etc.),
des statistiques liées à son utilisation (nombre de téléchargements, etc.)
chaque jeu de données téléversé sur la plateforme :
son nom,
son auteur (qui peut être une organisation ou une personne physique),
des caractéristiques concernant le modèle (nombre de lignes, type de données) dont certaines sont déclaratives ,
des statistiques liées à son utilisation (nombre de téléchargements, etc.)
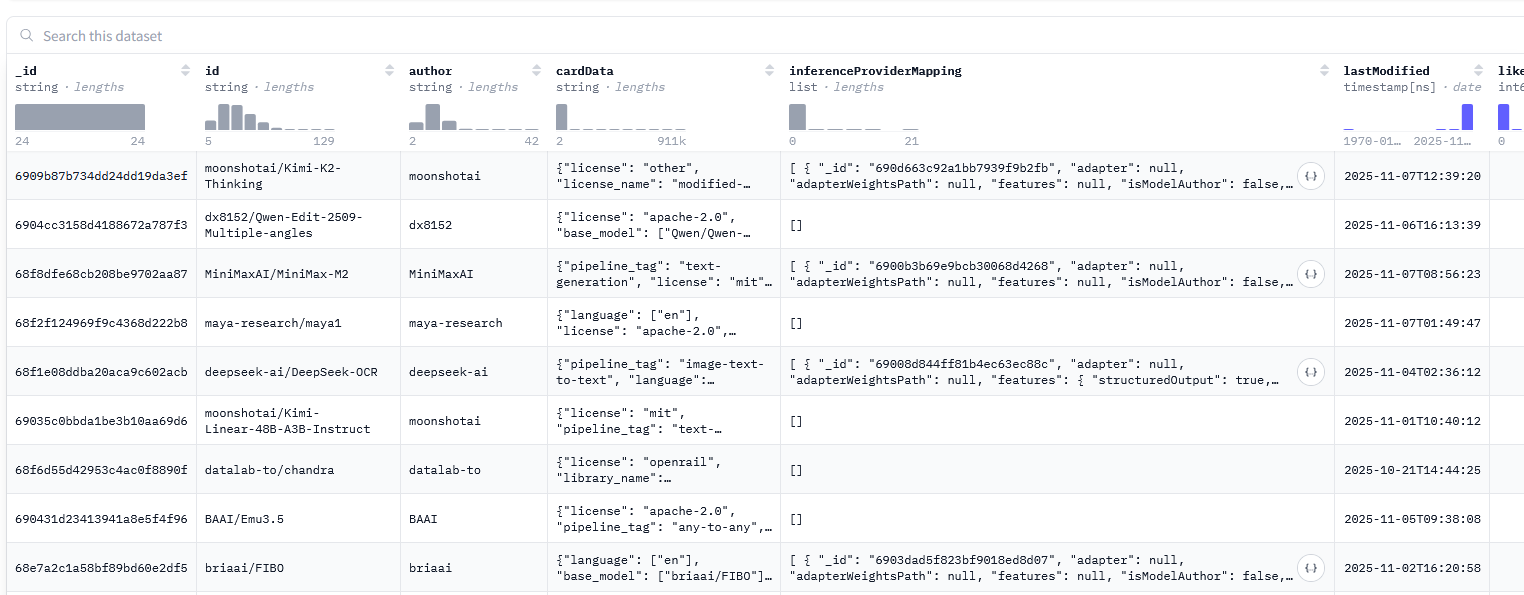
Figure 6 : Extrait de la base de données
Nous avons téléchargé cette base de données le 01/09/2025 et fondé nos analyses statistiques sur ce matériau. La base de données a les caractéristiques suivantes :
Nombre de modèles uniques dans la base de données : 2 020 532
Nombre de datasets dans la base de données : 486 390
Pourcentage de modèles avec base_model précisé (c’est-à-dire, pour lesquels il est indiqué le modèle à partir duquel un modèle a été obtenu par modification) : 29.01%
Pourcentage de modèles avec jeu de données d’entraînement précisé : 6,95 %
Par ailleurs, environ 88 % des modèles sont téléversés par des utilisateurs (personnes physiques) de Hugging Face, le reste étant téléversé par des comptes détenus par des organisations.